跳转到主要内容

    TiProxy 原理和实现


    说明

    在上篇《TiProxy 尝鲜》中做了一些实验,比如加减tidb节点后tiproxy可以做到自动负载均衡,如果遇到会话有未提交的事务则等待事务结束才迁移。

    本次主要研究这样的功能在tiproxy中是如何实现的,本次分享内容主要为以下几部分:

    • tiproxy是怎么发现tidb?
    • tiproxy是在tidb节点间自动负载均衡的逻辑?
    • 在自动负载均衡时tiproxy是怎么做到优雅的session迁移、session上下文恢复?
    • tiproxy在自动负载均衡期间遇到处于未提交事务的session是怎么等待结束的?

    Tiproxy 介绍

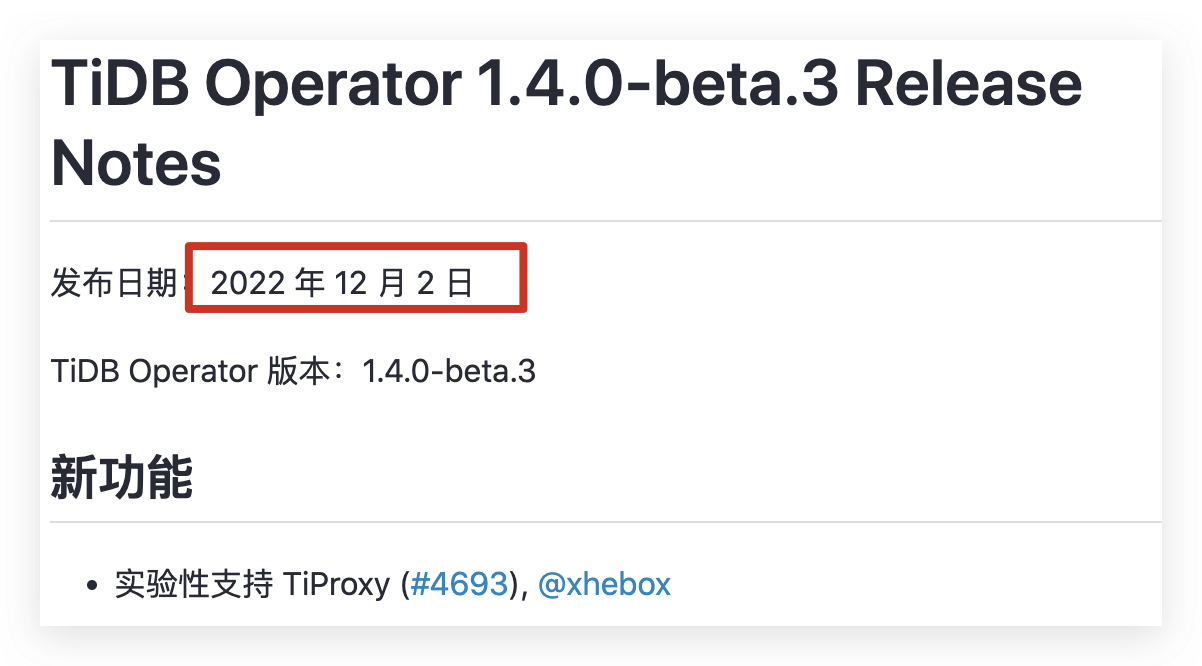
    tiproxy 在 2022年12月2日被operator支持

    Img

    相关的设计文档可以从官方 READMEgoole doc 中查看

    这个有个重要特性需要说明下:

    • tiproxy组件不会保存账号的密码,因为这是不安全的行为,所以当进行会话迁移的时候使用的是 session token 认证方式(下文会提到这种方式的实现原理)。

    声明

    目前tiproxy还处于实验阶段、功能还在持续开发中,本文讲述的内容跟日后GA版本可能存在差异,届时请各位看官留意。

    另外本人能力有限,在阅读源码中难免有理解不到位的地方,如有发现欢迎在评论区指正,感谢。

    开始发车

    原理分析

    1、tiproxy是怎么发现tidb?

    获取tidb拓扑最核心、简化后的代码如下,其实就是使用etcdCli.Get获取信息

    // 从 etcd 获取 tidb 拓扑 路径 /topology/tidb/<ip:port>/info /topology/tidb/<ip:port>/ttl
    func (is *InfoSyncer) GetTiDBTopology(ctx context.Context) (map[string]*TiDBInfo, error) {
        res, err := is.etcdCli.Get(ctx, tidbinfo.TopologyInformationPath, clientv3.WithPrefix())
        infos := make(map[string]*TiDBInfo, len(res.Kvs)/2)
        for _, kv := range res.Kvs {
            var ttl, addr string
            var topology *tidbinfo.TopologyInfo
            key := hack.String(kv.Key)
            switch {
            case strings.HasSuffix(key, ttlSuffix):
                addr = key[len(tidbinfo.TopologyInformationPath)+1 : len(key)-len(ttlSuffix)-1]
                ttl = hack.String(kv.Value)
            case strings.HasSuffix(key, infoSuffix):
                addr = key[len(tidbinfo.TopologyInformationPath)+1 : len(key)-len(infoSuffix)-1]
                json.Unmarshal(kv.Value, &topology)
            default:
                continue
            }
    
            info := infos[addr]
            if len(ttl) > 0 {
                info.TTL = hack.String(kv.Value)
            } else {
                info.TopologyInfo = topology
            }
        }
        return infos, nil
    }

    这个函数是怎么被tiproxy用起来的呢?

    其实在每个proxy启动时后都会开启一个BackendObserver协程,这个协程会做三件事:

    func (bo *BackendObserver) observe(ctx context.Context) {
        for ctx.Err() == nil {
            // 获取
            backendInfo, err := bo.fetcher.GetBackendList(ctx)
            // 检查
            bhMap := bo.checkHealth(ctx, backendInfo)
            // 通知
            bo.notifyIfChanged(bhMap)
    
            select {
            case <-time.After(bo.healthCheckConfig.Interval):  // 间隔3秒
            case <-bo.refreshChan:
            case <-ctx.Done():
                return
            }
        }
    }

    第一步获取:

    从etcd获取tidb拓扑;代码见上;

    第二步检查:

    判断获取到tidb节点是否可以连通、访问,给每个节点设置StatusHealthy或者StatusCannotConnect状态

    func (bo *BackendObserver) checkHealth(ctx context.Context, backends map[string]*BackendInfo) map[string]*backendHealth {
        curBackendHealth := make(map[string]*backendHealth, len(backends))
        for addr, info := range backends {
            bh := &backendHealth{
                status: StatusHealthy,
            }
            curBackendHealth[addr] = bh
            // http 服务检查
            if info != nil && len(info.IP) > 0 {
                schema := "http"
                httpCli := *bo.httpCli
                httpCli.Timeout = bo.healthCheckConfig.DialTimeout
                url := fmt.Sprintf("%s://%s:%d%s", schema, info.IP, info.StatusPort, statusPathSuffix)
                resp, err := httpCli.Get(url)
                if err != nil {
                    bh.status = StatusCannotConnect
                    bh.pingErr = errors.Wrapf(err, "connect status port failed")
                    continue
                }
            }
            // tcp 服务检查
            conn, err := net.DialTimeout("tcp", addr, bo.healthCheckConfig.DialTimeout)
            if err != nil {
                bh.status = StatusCannotConnect
                bh.pingErr = errors.Wrapf(err, "connect sql port failed")
            }        
        }
        return curBackendHealth
    }

    第三步通知:

    将检查后的 backends 列表跟内存中缓存的 backends 进行比较,将变动的 updatedBackends 进行通知

    // notifyIfChanged 根据最新的 tidb 拓扑 bhMap 与之前的 tidb 拓扑 bo.curBackendInfo 进行比较
    // - 在 bo.curBackendInfo 中但是不在 bhMap 中:说明 tidb 节点失联,需要记录下
    // - 在 bo.curBackendInfo 中也在 bhMap 中,但是最新的状态不是 StatusHealthy:也需要记录下
    // - 在 bhMap 中但是不在 bo.curBackendInfo 中:说明是新增 tidb 节点,需要记录下
    func (bo *BackendObserver) notifyIfChanged(bhMap map[string]*backendHealth) {
        updatedBackends := make(map[string]*backendHealth)
        for addr, lastHealth := range bo.curBackendInfo {
            if lastHealth.status == StatusHealthy {
                if newHealth, ok := bhMap[addr]; !ok {
                    updatedBackends[addr] = &backendHealth{
                        status:  StatusCannotConnect,
                        pingErr: errors.New("removed from backend list"),
                    }
                    updateBackendStatusMetrics(addr, lastHealth.status, StatusCannotConnect)
                } else if newHealth.status != StatusHealthy {
                    updatedBackends[addr] = newHealth
                    updateBackendStatusMetrics(addr, lastHealth.status, newHealth.status)
                }
            }
        }
        for addr, newHealth := range bhMap {
            if newHealth.status == StatusHealthy {
                lastHealth, ok := bo.curBackendInfo[addr]
                if !ok {
                    lastHealth = &backendHealth{
                        status: StatusCannotConnect,
                    }
                }
                if lastHealth.status != StatusHealthy {
                    updatedBackends[addr] = newHealth
                    updateBackendStatusMetrics(addr, lastHealth.status, newHealth.status)
                } else if lastHealth.serverVersion != newHealth.serverVersion {
                    // Not possible here: the backend finishes upgrading between two health checks.
                    updatedBackends[addr] = newHealth
                }
            }
        }
        // Notify it even when the updatedBackends is empty, in order to clear the last error.
        bo.eventReceiver.OnBackendChanged(updatedBackends, nil)
        bo.curBackendInfo = bhMap
    }

    通过上面的步骤就获取到了变动的backends,将这些变动从 BackendObserver 模块同步给 ScoreBasedRouter 模块。

    2、tiproxy是在tidb节点间自动负载均衡的逻辑?

    此处自动负载的语义是:将哪个 backend 的哪个 connect 迁移到哪个 backend 上。这就要解决 backend 挑选和 connect 挑选问题。

    这个问题的解决办法是在 ScoreBasedRouter 模块完成。这个模块有3个 func 和上述解释相关:

    type ScoreBasedRouter struct {
        sync.Mutex
        // A list of *backendWrapper. The backends are in descending order of scores.
        backends     *glist.List[*backendWrapper]
        // ...
    }
    
    // 被 BackendObserver 调用,传来的 backends 会合并到 ScoreBasedRouter::backends 中
    func (router *ScoreBasedRouter) OnBackendChanged(backends map[string]*backendHealth, err error) {}
    
    // 通过比较 backend 分数方式调整 ScoreBasedRouter::backends 中的位置
    func (router *ScoreBasedRouter) adjustBackendList(be *glist.Element[*backendWrapper]) {}
    
    // 协程方式运行,做负载均衡处理
    func (router *ScoreBasedRouter) rebalanceLoop(ctx context.Context) {}

    OnBackendChanged 是暴露给 BackendObserver 模块的一个接口, 用来同步从 etcd 发现的 tidb 信息,这个逻辑不复杂,详细可自行阅读源码。这个方法是问题一种提到的“通知”接收处。

    adjustBackendList 本质就是调整 item 在双向链表中的位置,这个也不复杂。

    下面重点说下 rebalanceLoop 的逻辑,这里涉及到"将哪个 backend 的哪个 connect 迁移到哪个 backend 上"的问题。

    // rebalanceLoop 计算间隔是 10 ms,每次最多处理 10 个连接(防止后端出现抖动)
    // - backends 的变化是通过 OnBackendChanged 修改的,连接平衡是 rebalanceLoop 函数做的,两者为了保证并发使用了 sync.Mutex
    func (router *ScoreBasedRouter) rebalanceLoop(ctx context.Context) {
        for {
            router.rebalance(rebalanceConnsPerLoop)
            select {
            case <-ctx.Done():
                return
            case <-time.After(rebalanceInterval):
            }
        }
    }
    
    // rebalance
    func (router *ScoreBasedRouter) rebalance(maxNum int) {
        curTime := time.Now()
        router.Lock()
        defer router.Unlock()
        for i := 0; i < maxNum; i++ {
            var busiestEle *glist.Element[*backendWrapper]
            for be := router.backends.Front(); be != nil; be = be.Next() {
                backend := be.Value
                if backend.connList.Len() > 0 {
                    busiestEle = be
                    break
                }
            }
            if busiestEle == nil {
                break
            }
            busiestBackend := busiestEle.Value
            idlestEle := router.backends.Back()
            idlestBackend := idlestEle.Value
            if float64(busiestBackend.score())/float64(idlestBackend.score()+1) < rebalanceMaxScoreRatio {
                break
            }
            var ce *glist.Element[*connWrapper]
            for ele := busiestBackend.connList.Front(); ele != nil; ele = ele.Next() {
                conn := ele.Value
                switch conn.phase {
                case phaseRedirectNotify:
                    continue
                case phaseRedirectFail:
                    if conn.lastRedirect.Add(redirectFailMinInterval).After(curTime) {
                        continue
                    }
                }
                ce = ele
                break
            }
            if ce == nil {
                break
            }
            conn := ce.Value
            busiestBackend.connScore--
            router.adjustBackendList(busiestEle)
            idlestBackend.connScore++
            router.adjustBackendList(idlestEle)
            conn.phase = phaseRedirectNotify
            conn.lastRedirect = curTime
            conn.Redirect(idlestBackend.addr)
        }
    }

    rebalance 的逻辑

    • 从前往后访问 backends list,找到 busiestBackend
    • 在 backends list 最后找到 idlestBackend
    • 比较两者 score, 如果差距在 20% 以内就不用处理了
    • 否则在 busiestBackend 中取出一个 conn 给 idlestBackend
      • 取出的逻辑很简单,就是从前到后遍历当前 backend 的 connList
      • 因为session迁移要保证事务完成,所以迁移不是立刻执行的,这就得加个 phase 来跟进
        • 处于 phaseRedirectNotify 阶段的不要再取出;
        • 处于 phaseRedirectFail 但还没到超时时间的,也不要取出;
      • 其他状态的 conn 可以被取出
    • 因为有 conn 变动所以要调整下 busiestBackend 和 idlestBackend 在 backends list 中的位置
    • 最后通过 channel 通知 BackendConnManager 做去session迁移,此时 conn 状态是 phaseRedirectNotify

    给每个backend的打分逻辑如下,分数越大说明负载越大

    func (b *backendWrapper) score() int {
        return b.status.ToScore() + b.connScore
    }
    
    // var statusScores = map[BackendStatus]int{
    //     StatusHealthy:        0,
    //     StatusCannotConnect:  10000000,
    //     StatusMemoryHigh:     5000,
    //     StatusRunSlow:        5000,
    //     StatusSchemaOutdated: 10000000,
    // }
    
    // connScore = connList.Len() + incoming connections - outgoing connections.

    3、在自动负载均衡时tiproxy是怎么做到优雅的session迁移、session上下文恢复?

    这个问题可以继续细分:

    • 迁移消息接收
      • ScoreBasedRouter 模块计算出哪个 conn 从哪个 backend 迁移到哪个 backend 后,怎么通知给对应的 conn ?
    • 迁移任务执行
      • conn 接收到消息后要进行session迁移,那么如何解决迁移期间 client 可能存在访问的问题 ?
      • 因为tiproxy没有保存密码,那么基于session token的验证方式是怎么实现的?
      • 新的tidb节点登录成功后,session上下问题信息是怎么恢复的?

    以上的问题都可以在 BackendConnManager 模块找到答案:

    type BackendConnManager struct {
        // processLock makes redirecting and command processing exclusive.
        processLock sync.Mutex
        clientIO   *pnet.PacketIO
        backendIO        atomic.Pointer[pnet.PacketIO]
        authenticator  *Authenticator
    }
    func (mgr *BackendConnManager) Redirect(newAddr string) bool {}
    func (mgr *BackendConnManager) processSignals(ctx context.Context) {}
    func (mgr *BackendConnManager) tryRedirect(ctx context.Context) {}
    func (mgr *BackendConnManager) querySessionStates(backendIO *pnet.PacketIO) (sessionStates, sessionToken string, err error) {}
    func (mgr *BackendConnManager) ExecuteCmd(ctx context.Context, request []byte) (err error) {}

    迁移消息接收

    在前文的 rebalance 方法最后,有行这样的逻辑

        conn.Redirect(idlestBackend.addr)

    这就是 ScoreBasedRouter 的通知给对应 conn 的地方。

    这里调用的是 BackendConnManager::Redirect, 具体执行逻辑

    • 将目标 backend 存储到 redirectInfo
    • 给 signalReceived channel 发 signalTypeRedirect 消息
    func (mgr *BackendConnManager) Redirect(newAddr string) bool {
        // NOTE: BackendConnManager may be closing concurrently because of no lock.
        switch mgr.closeStatus.Load() {
        case statusNotifyClose, statusClosing, statusClosed:
            return false
        }
        mgr.redirectInfo.Store(&signalRedirect{newAddr: newAddr})
        // Generally, it won't wait because the caller won't send another signal before the previous one finishes.
        mgr.signalReceived <- signalTypeRedirect
        return true
    }

    该消息被 BackendConnManager::processSignals 协程接收

    func (mgr *BackendConnManager) processSignals(ctx context.Context) {
        for {
            select {
            case s := <-mgr.signalReceived:
                // Redirect the session immediately just in case the session is finishedTxn.
                mgr.processLock.Lock()
                switch s {
                case signalTypeGracefulClose:
                    mgr.tryGracefulClose(ctx)
                case signalTypeRedirect:   // <<<<<<<<<<<<<<<<<<
                    mgr.tryRedirect(ctx)   
                }
                mgr.processLock.Unlock()
            case rs := <-mgr.redirectResCh:
                mgr.notifyRedirectResult(ctx, rs)
            case <-mgr.checkBackendTicker.C:
                mgr.checkBackendActive()
            case <-ctx.Done():
                return
            }
        }
    }

    这里补充下 processSignals 是怎么来的。正常情况下,client每发起一个连接,proxy就会起两个协程:

    • 连接、转发 tcp 消息协程:
      • 连接:SQLServer::Run 方法启动,也就是每连接每协程的意思。
      • 转发:ClientConnection 模块调用 BackendConnManager::ExecuteCmd 实现消息转发
    • 监听和执行 redirect 任务协程:
      • BackendConnManager 模块启动 processSignals 协程处理

    所以上文监听 signalTypeRedirect 消息的 processSignals 协程,在连接建立时就启动了,当收到消息后执行 tryRedirect 方法尝试执行迁移。

    迁移任务执行

    tryRedirect 处理逻辑比较复杂,我们选取核心流程进行简述:

    func (mgr *BackendConnManager) tryRedirect(ctx context.Context) {
        // 获取目标 backend
        signal := mgr.redirectInfo.Load()
        // 处于事务中,先不做迁移
        if !mgr.cmdProcessor.finishedTxn() {
            return
        }
        // 组装执行结果
        rs := &redirectResult{
            from: mgr.ServerAddr(),
            to:   signal.newAddr,
        }
        defer func() {
            // 不论执行成功与否都清空 redirectInfo, 并将 rs 结果发到 redirectResCh, redirectResCh 的处理逻辑还是在 processSignals 中处理
            mgr.redirectInfo.Store(nil)
            mgr.redirectResCh <- rs
        }()
        // 从源 backend 获取 sessionStates, sessionToken
        backendIO := mgr.backendIO.Load()
        sessionStates, sessionToken, rs.err := mgr.querySessionStates(backendIO)
        // 跟目标 backend 建立tcp连接
        cn, rs.err := net.DialTimeout("tcp", rs.to, DialTimeout)
        // 将 conn 包裹为 PacketIO
        newBackendIO := pnet.NewPacketIO(cn, mgr.logger, pnet.WithRemoteAddr(rs.to, cn.RemoteAddr()), pnet.WithWrapError(ErrBackendConn))
        // 使用 session token方式跟目标 backend 进行鉴握手鉴权
        mgr.authenticator.handshakeSecondTime(mgr.logger, mgr.clientIO, newBackendIO, mgr.backendTLS, sessionToken)
        // 登录目标 backend 进行鉴权
        rs.err = mgr.initSessionStates(newBackendIO, sessionStates)
        // 将新的 PacketIO 存储到 BackendConnManager 的成员变量中,后续再有请求都是用此变量
        mgr.backendIO.Store(newBackendIO)
    }

    上面展示了 session token 的认证方式和上下文恢复的逻辑,对应 querySessionStates 、handshakeSecondTime 、initSessionStates 三个方法

    • querySessionStates: tiproxy 在 tidb a 上执行 SHOW SESSION_STATES 获取到 session_token session_state
    • handshakeSecondTime: tiproxy 使用 session_token 认证方式登录到 tidb b
    • initSessionStates: tiproxy 登录成功后执行 SET SESSION_STATES ‘%s’ 设置 tidb b 的 session_state

    补充:

    • tiproxy 使用的 session token 的方式可以理解为 tidb 丰富了 mysql 协议,在 client 登录 server 的时候,除了账号密码这种mysql_native_password方式,还支持了账号token方式。
    • 使用 session token 认证方式,要求整个tidb集群证书是一样的,这样tidb a签名,tidb b才可以验签通过。

    为了方式迁移期间,client还有新的会话,在执行 tryRedirect 前后使用 sync.Mutex 进行保护

    func (mgr *BackendConnManager) processSignals(ctx context.Context) {
        for {
                // ...
                mgr.processLock.Lock()
                switch s {
                case signalTypeRedirect:
                    mgr.tryRedirect(ctx)
                }
                mgr.processLock.Unlock()
                // ...
            }
        }
    }
    
    func (mgr *BackendConnManager) ExecuteCmd(ctx context.Context, request []byte) (err error) {
        // ...
        mgr.processLock.Lock()
        defer mgr.processLock.Unlock()
        // ...
        waitingRedirect := mgr.redirectInfo.Load() != nil
        // ...
        if waitingRedirect {
            mgr.tryRedirect(ctx)
        }
        // ...
    }

    4、tiproxy在自动负载均衡期间遇到处于未提交事务的session是怎么等待结束的?

    对于 tryRedirect 方法有两个地方被调用,即前文提到的 BackendConnManager::processSignals 和 BackendConnManager::ExecuteCmd

    BackendConnManager::processSignals 只有在收到channe消息后立即出发一次,如果有未完成的事务就不再执行了。

    所以为了保证迁移任务可继续,在 BackendConnManager::ExecuteCmd 中每次执行完 executeCmd 后尝试迁移,这样就能保证事务结束后立刻迁移。

    func (mgr *BackendConnManager) ExecuteCmd(ctx context.Context, request []byte) (err error) {
        // ...
        waitingRedirect := mgr.redirectInfo.Load() != nil
        // ...
        holdRequest, err = mgr.cmdProcessor.executeCmd(request, mgr.clientIO, mgr.backendIO.Load(), waitingRedirect)
        // ...
        if mgr.cmdProcessor.finishedTxn() {
            if waitingRedirect {
                mgr.tryRedirect(ctx)
            }
            // ...
        }
        // ...
    }

    判断事务是否结束的 finishedTxn 方法逻辑:解析 client 的请求类型、解析 backend 的响应状态综合判断事务是否完成,此逻辑过于硬核,等以后研究明白后再分享吧。

    有兴趣的读者可以分析下这段逻辑:

    func (cp *CmdProcessor) finishedTxn() bool {
        if cp.serverStatus&(StatusInTrans|StatusQuit) > 0 {
            return false
        }
        // If any result of the prepared statements is not fetched, we should wait.
        return !cp.hasPendingPreparedStmts()
    }
    
    func (cp *CmdProcessor) updatePrepStmtStatus(request []byte, serverStatus uint16) {
        var (
            stmtID         int
            prepStmtStatus uint32
        )
        cmd := pnet.Command(request[0])
        switch cmd {
        case pnet.ComStmtSendLongData, pnet.ComStmtExecute, pnet.ComStmtFetch, pnet.ComStmtReset, pnet.ComStmtClose:
            stmtID = int(binary.LittleEndian.Uint32(request[1:5]))
        case pnet.ComResetConnection, pnet.ComChangeUser:
            cp.preparedStmtStatus = make(map[int]uint32)
            return
        default:
            return
        }
        switch cmd {
        case pnet.ComStmtSendLongData:
            prepStmtStatus = StatusPrepareWaitExecute
        case pnet.ComStmtExecute:
            if serverStatus&mysql.ServerStatusCursorExists > 0 {
                prepStmtStatus = StatusPrepareWaitFetch
            }
        case pnet.ComStmtFetch:
            if serverStatus&mysql.ServerStatusLastRowSend == 0 {
                prepStmtStatus = StatusPrepareWaitFetch
            }
        }
        if prepStmtStatus > 0 {
            cp.preparedStmtStatus[stmtID] = prepStmtStatus
        } else {
            delete(cp.preparedStmtStatus, stmtID)
        }
    }

    总结

    本文从4个疑惑入手,阅读了下tiproxy的代码实现,都找到了对应的处理逻辑。

    对比于tidb、tikv、pd等组件代码,tiproxy实简单很多,推荐大家学习下。

    彩蛋

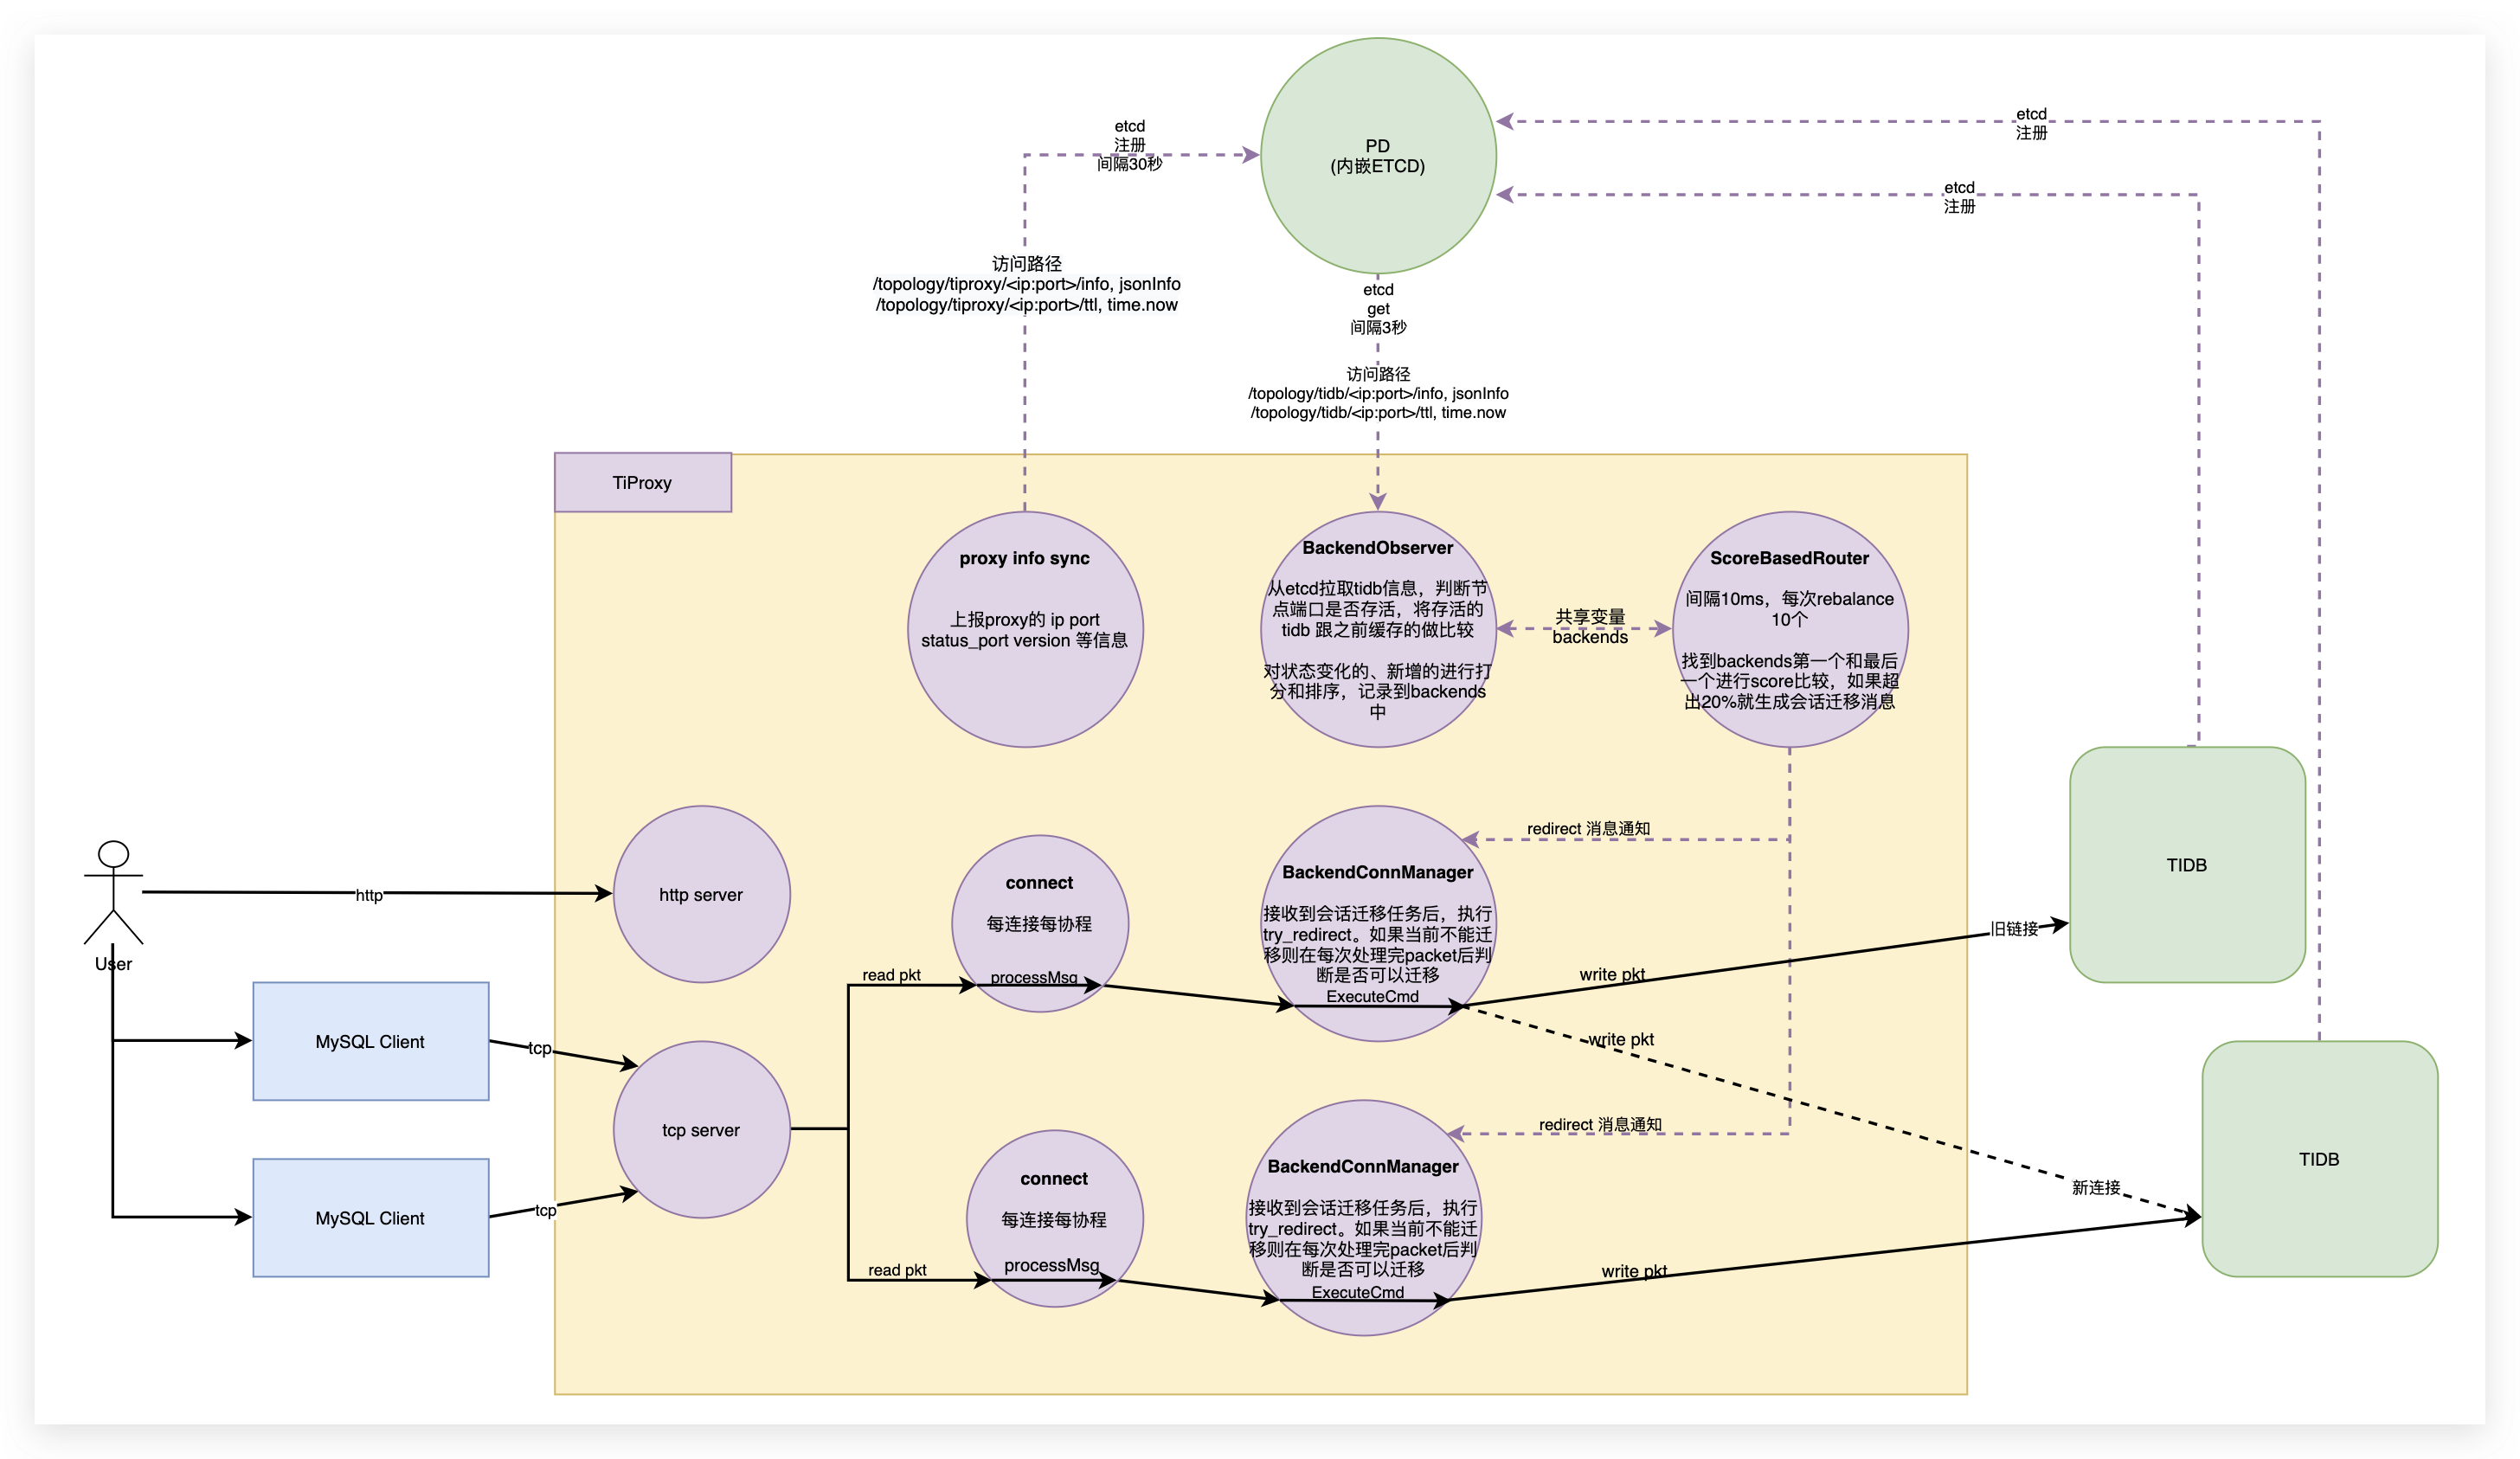
    在梳理上面4个问题的时,理清思路后,绘制了如下的内部交互图,有兴趣的可以自己研究下,下篇文章我们将对其进行说明。

    Img